Automatiser un blog devient fragile lorsqu’un seul modèle d’IA prend en charge toutes les tâches et publie sans vérifications. La rotation des modèles d’IA offre une approche plus contrôlée : sélectionner des modèles pour des tâches éditoriales précises, évaluer les remplaçants avant leur déploiement et séparer les autorisations de publication de la génération de texte.
Ce guide explique comment mettre en place ce flux de travail, de la recherche et de la rédaction à la planification dans WordPress et à la migration des modèles. L’objectif n’est pas de courir après chaque nouvelle version, mais de créer un processus de publication qui reste utile malgré l’évolution des modèles, des API, des sources et des exigences éditoriales.
Ce que signifie la rotation des modèles d’IA pour la publication d’un blog
La rotation des modèles d’IA désigne l’utilisation contrôlée de modèles d’IA dans un flux de publication, ou leur remplacement. Un routeur de modèles attribue chaque tâche à un modèle approuvé, tandis que des vérifications éditoriales déterminent si le contenu obtenu peut avancer vers la publication. La rotation peut avoir lieu d’une tâche à l’autre, après la mise à jour d’un modèle ou lorsqu’un modèle de secours approuvé est nécessaire.
Ces situations sont liées, mais nécessitent des décisions différentes. Confier la génération des titres à un modèle léger relève du routage des tâches. Remplacer un modèle de rédaction en fin de vie relève de la migration. Rediriger une requête qui a échoué vers un autre modèle approuvé relève du basculement vers un modèle de secours.
- Routage des tâches : choisir un modèle en fonction de la difficulté, des besoins en contexte, des exigences de latence et des conséquences propres à une tâche.
- Rotation des versions : remplacer un modèle existant après avoir évalué une version plus récente au regard de vos exigences éditoriales.
- Routage de secours : utiliser une solution de remplacement testée lorsque le modèle privilégié est indisponible ou ne peut pas mener à bien une tâche admissible.
Les recommandations d’OpenAI sur le choix des modèles préconisent de commencer par une sélection explicite et d’adapter le modèle à la tâche. Cela favorise une architecture de publication réfléchie plutôt qu’un flux qui envoie chaque requête au modèle le plus récent.
Pour un blog, cette distinction est importante, car créer des étiquettes thématiques n’équivaut pas à vérifier une explication technique. Une étiquette plausible a peu de conséquences ; une affirmation non étayée sur un produit peut compromettre tout l’article.
Faites tourner les modèles en fonction du travail qu’ils doivent accomplir, et non simplement parce qu’un autre modèle vient de sortir.
La rotation n’impose pas non plus d’utiliser plusieurs fournisseurs. Vous pouvez commencer par différents modèles approuvés au sein de l’écosystème d’un seul fournisseur, ou conserver un modèle principal et un modèle de remplacement testé. Le routage entre plusieurs fournisseurs est une possibilité lorsque ses avantages justifient le travail supplémentaire d’intégration et d’évaluation.
Cartographier le flux éditorial avant de choisir les modèles
Commencez par le processus de publication, et non par le catalogue de modèles. Notez les entrées, les résultats attendus, les critères d’acceptation et les autorisations de chaque étape. Sinon, un routeur ne fera que répartir une tâche mal définie entre davantage de systèmes.
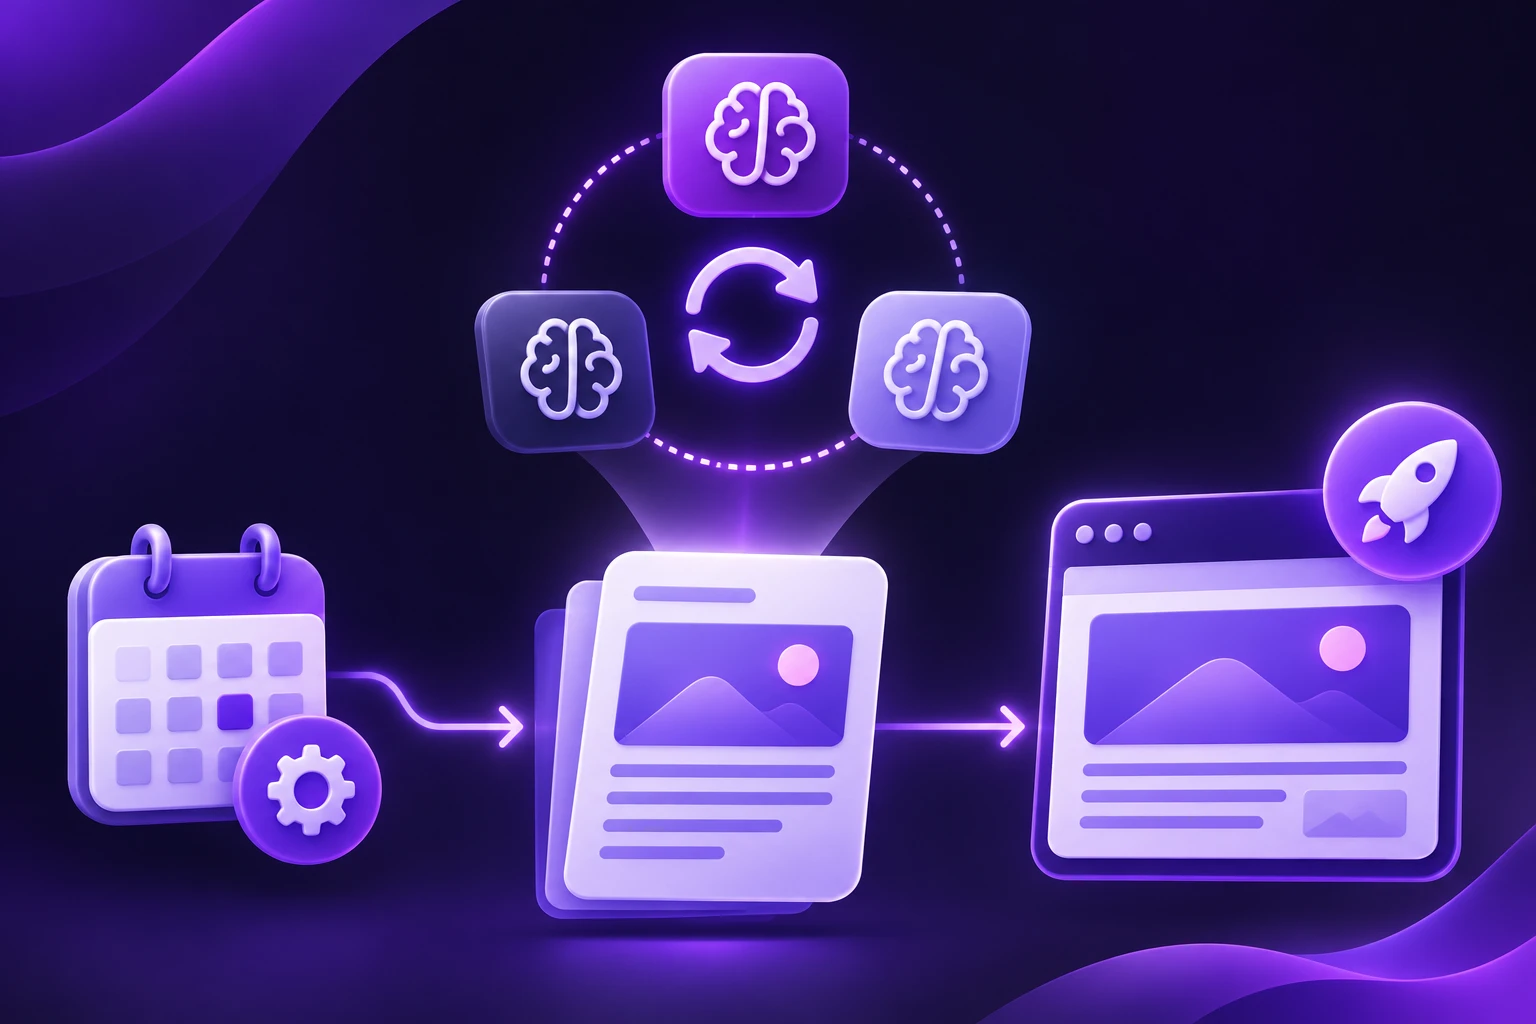
Un flux de travail pratique sépare des décisions souvent regroupées dans une seule longue consigne. La recherche détermine ce qui peut être affirmé. La rédaction organise et explique ces éléments. La révision améliore l’article. La publication modifie l’état de votre site web.
- Créer le brief. Définissez le lectorat, l’intention de recherche, le mot-clé principal, l’objectif de l’article, les sections requises et les sujets à exclure.
- Rassembler des éléments probants approuvés. Collectez des extraits de sources, de la documentation interne, des spécifications de produits ou d’autres contenus que l’article est autorisé à utiliser.
- Élaborer le plan. Organisez les questions du lectorat dans un ordre utile et indiquez où des éléments probants sont nécessaires.
- Générer le brouillon. Rédigez en respectant le brief et les limites des éléments probants, en signalant les lacunes plutôt qu’en les comblant par des suppositions.
- Vérifier les affirmations et la qualité éditoriale. Contrôlez l’étayage factuel, l’utilité, la langue, la structure et le respect de la marque.
- Valider le dossier de publication. Vérifiez le HTML, les métadonnées, les liens, les images, les catégories et les paramètres de destination.
- Approuver et planifier. N’autorisez un composant de publication distinct à intervenir qu’une fois toutes les approbations requises obtenues.
Définir le contenu requis à chaque transfert
Chaque étape doit produire un résultat prévisible. Un brief peut contenir une description du public cible et un angle approuvé. Un brouillon doit inclure le contenu ainsi qu’une liste des affirmations. Une révision doit signaler des problèmes précis qui bloquent le processus, plutôt que de formuler une consigne ambiguë comme « améliore ça ».
Prenons l’exemple d’un article sur une intégration logicielle. L’étape de recherche fournit des exigences de configuration étayées. L’étape de rédaction explique la procédure. Un réviseur compare chaque affirmation sur la compatibilité avec la documentation approuvée, tandis que le validateur de publication vérifie que les captures d’écran du tutoriel comportent les descriptions requises.
Cette séparation vous aide à identifier la véritable origine d’un échec. Si le dossier de preuves a omis une limite importante, remplacer le modèle de rédaction ne résoudra probablement pas le problème de fond.
Elle vous offre également une solution plus simple qu’une automatisation complète : automatiser les briefs, les plans et les premiers brouillons, tout en conservant la révision humaine et la publication manuelle. C’est un bon point de départ lorsque le flux de travail n’est pas encore stabilisé.
Construire un routeur de modèles reposant sur des règles explicites pour chaque tâche
Un routeur de modèles est le composant qui transforme une tâche éditoriale en requête adressée à un modèle approuvé. Il doit s’appuyer sur une configuration centralisée et maintenue, plutôt que sur des noms de modèles dispersés dans des scripts, des consignes, des extensions et des tâches de publication.
Utilisez des noms de rôles internes comme outline_writer, draft_writer et editorial_reviewer. Associez ces rôles aux identifiants de modèles réels dans une couche de configuration unique. La modification de ces associations devient ainsi un changement opérationnel contrôlé, plutôt qu’une recherche dans toute l’application.
Orienter les tâches selon leurs exigences, et non selon la réputation des modèles
Pour chaque rôle, documentez les capacités minimales requises. Parmi les critères pertinents figurent la quantité de sources, les besoins de sortie structurée, l’accès aux outils, le délai de réponse attendu et les conséquences éditoriales d’une erreur.
- Tâches pouvant convenir à un modèle léger : suggérer des titres à partir d’un brief approuvé, classer des articles dans une taxonomie existante ou proposer des méta-descriptions à partir d’un contenu finalisé.
- Tâches complexes possibles : rapprocher des extraits de sources contradictoires, restructurer un brouillon difficile ou vérifier un argument technique par rapport aux éléments probants fournis.
- Tâches sans modèle : vérifier les champs obligatoires, valider la structure HTML, détecter les doublons dans les tâches de publication et faire respecter les autorisations de publication.
Il s’agit d’hypothèses de départ, et non de garanties de qualité des modèles. Un modèle moins coûteux peut convenir à une tâche de rédaction étroitement cadrée, tandis qu’une tâche de classification apparemment simple peut devenir difficile si la taxonomie est ambiguë. Ce sont vos résultats d’évaluation qui doivent déterminer l’affectation.
Masquer les différences entre fournisseurs derrière un adaptateur
Un adaptateur de fournisseur traduit votre requête interne dans le format d’API pris en charge par le fournisseur et normalise la réponse. Dans la mesure du possible, gardez les formats de messages propres aux fournisseurs, les définitions d’outils, la gestion des erreurs et l’authentification à l’écart du flux éditorial.
L’adaptateur doit préserver les différences importantes au lieu de prétendre que tous les modèles prennent en charge les mêmes fonctionnalités. Si une tâche exige un outil ou une contrainte de sortie particulière, le routeur doit écarter les modèles incapables de répondre à cette exigence.
Pour chaque exécution, consignez le fournisseur et l’identifiant du modèle sélectionnés, la version de la consigne, la version du dossier de sources et le résultat de la tâche. Vous pourrez ainsi déterminer si une variation de qualité provient d’une rotation de modèle, d’une consigne modifiée ou d’entrées différentes.
Enfin, gardez une politique de routage compréhensible. Un petit nombre de règles explicites est plus facile à tester qu’un second système d’IA chargé de prendre sans contrainte les décisions de sélection des modèles. N’ajoutez un routage dynamique que si vous pouvez expliquer la décision et mesurer son apport au flux de travail.
Ancrer les brouillons dans des éléments probants avant de peaufiner le référencement naturel
Un modèle plus performant ne remplace pas des sources fiables. Si vous souhaitez publier des articles factuels, fournissez au flux de travail un dossier de preuves défini et faites des affirmations non étayées un motif de blocage, plutôt qu’une simple question de style.
Le livre blanc de HCLTech sur la gouvernance des contenus générés par l’IA insiste sur l’utilisation de sources fiables, la génération encadrée et la révision humaine. Appliqué à la rédaction de blog, cela signifie préciser ce que le modèle peut utiliser, ce qu’il ne doit pas déduire et qui est responsable de l’approbation du résultat.
Créer un dossier de sources que le réviseur peut examiner
Enregistrez le titre et l’emplacement de la source, l’extrait pertinent et l’affirmation qu’il étaye. Lorsque la fraîcheur des informations est importante, indiquez la date à laquelle votre équipe a récupéré ou vérifié le contenu. Ne demandez pas au modèle d’inventer une citation lorsqu’une source manque.
Par exemple, une annonce de produit peut étayer l’affirmation qu’une fonctionnalité a été annoncée. Elle ne permet pas nécessairement d’établir que cette fonctionnalité est activée pour tous les clients, prise en charge dans toutes les régions ou disponible avec tous les abonnements. Ces affirmations plus générales nécessitent leurs propres éléments probants.
- Exigez des éléments probants pour les chiffres, les dates, les affirmations sur la disponibilité, les comparaisons et les propos attribués.
- Distinguez les faits sourcés des recommandations, des exemples hypothétiques et des appréciations éditoriales.
- Signalez les éléments probants contradictoires ou incomplets pour examen au lieu de retenir discrètement la version la plus commode.
- Vérifiez qu’une source étaye la formulation exacte d’une affirmation, et pas seulement le sujet en général.
Utiliser la vérification par un modèle comme aide, et non comme preuve
Un modèle chargé de la vérification peut comparer un brouillon aux extraits fournis et signaler les lacunes apparentes. Il ne peut pas établir la véracité d’une affirmation simplement parce qu’il est d’accord avec le modèle de rédaction. Même des résultats issus de modèles indépendants peuvent répéter la même supposition non étayée.
Pour les éléments qui dépendent d’informations externes à jour, le flux de travail doit inclure un processus de recherche approuvé ou une vérification humaine. Si aucun des deux n’est disponible, reformulez l’affirmation de manière plus restreinte, supprimez-la ou mettez l’article en attente.
Procédez à l’optimisation SEO une fois que l’article repose sur une base factuelle défendable. Demandez à cette étape d’améliorer les titres, la pertinence, les suggestions de liens internes et le texte destiné aux résultats de recherche, sans ajouter de nouvelles affirmations factuelles. Cela évite qu’une étape d’optimisation annule les contraintes imposées pendant la recherche.
La couverture des mots-clés doit aider le lecteur à s’orienter dans le sujet. Elle ne doit pas transformer un article clair en une suite d’expressions répétées, ni encourager des affirmations non étayées sous prétexte qu’elles pourraient correspondre à une requête.
Relier la génération de contenu par l’IA à WordPress en toute sécurité
La génération et la publication de contenu doivent être des fonctionnalités distinctes. Le composant qui rédige un article n’a pas besoin d’avoir les autorisations lui permettant de le publier sans restriction, de modifier les paramètres du site ou de modifier d’autres articles sans rapport.
WordPress.com a annoncé des fonctionnalités d’agents d’IA permettant de créer, modifier et gérer du contenu. L’écosystème d’extensions WordPress.org comprend également des flux de rédaction et de publication automatique par IA, notamment des fonctionnalités de génération avec mise en file d’attente. Ces options montrent que des intégrations existent, mais ne garantissent pas que toutes les installations offrent les mêmes contrôles.
Choisir une intégration en fonction des exigences de contrôle
Une extension peut convenir si vous souhaitez disposer d’une interface dans WordPress et que votre flux de travail correspond aux fonctionnalités prises en charge. Un service d’orchestration externe peut être préférable si vous avez besoin d’un routage de modèles personnalisé, du stockage de preuves, de règles d’approbation ou de journaux d’exécution détaillés.
Avant de choisir l’une ou l’autre approche, vérifiez la gestion des identifiants, du statut de brouillon, de la planification, des nouvelles tentatives et des mises à jour. Les fonctionnalités de WordPress.com et celles d’une installation WordPress auto-hébergée ne sont pas interchangeables ; vérifiez ce que prennent en charge votre site et votre intégration.
- Créer un dossier de publication. Incluez le HTML approuvé, le titre, le slug, l’extrait, les métadonnées et les informations requises sur les taxonomies ou les médias.
- Valider le dossier. Rejetez les champs obligatoires manquants, le balisage mal formé, les liens non approuvés et tout contenu comportant encore des notes éditoriales non résolues.
- Enregistrer un brouillon. Conservez l’identifiant du contenu renvoyé afin que les opérations ultérieures mettent à jour le bon article.
- Vérifier la page affichée. Contrôlez les titres, les listes, les liens, les images et la mise en page dans le thème de destination.
- Ne planifier qu’après approbation. Confirmez l’heure de publication prévue et le fuseau horaire du site avant de modifier le statut de publication.
Utilisez les autorisations les plus restreintes prises en charge par votre intégration. Ne placez pas de secrets dans les consignes ou le contenu généré, et n’autorisez pas le texte d’un document source à redéfinir les consignes de publication.
Éviter les doublons et les actions de publication partielles
Attribuez un identifiant stable à chaque tâche d’article et enregistrez son état de publication. Avant de relancer une requête, déterminez si la tentative précédente a déjà créé le brouillon. Sinon, une réponse réseau incertaine risque de créer des doublons dans votre file d’attente.
Conservez la trace de la dernière version approuvée afin qu’un rédacteur puisse la restaurer si une mise à jour ultérieure pose problème. Une réponse API réussie ne signifie pas que le résultat éditorial est satisfaisant ; l’article affiché doit toujours correspondre au dossier approuvé.
Planifier les migrations de modèles avant leur retrait
La rotation des modèles devient plus facile lorsque la migration est traitée comme une opération de maintenance courante plutôt que comme une urgence. Tenez à jour un inventaire des modèles utilisés par chaque flux de travail, des fonctionnalités dont ils dépendent et de la personne chargée d’approuver les remplaçants.
Les consignes d’Anthropic sur les dépréciations indiquent que les clients ayant des déploiements actifs reçoivent un préavis d’au moins 60 jours avant le retrait des modèles rendus publics. Sa documentation sur la migration décrit également des changements concernant les anciennes interfaces et les clients. La leçon opérationnelle est de suivre à la fois la disponibilité des modèles et la compatibilité des intégrations.
Le catalogue de modèles et les recommandations de migration d’OpenAI soulignent également l’importance d’une sélection explicite des modèles. Un identifiant de modèle est une dépendance, et modifier cette dépendance peut nécessiter davantage qu’un simple changement de nom dans la configuration.
Suivre une procédure de migration reproductible
- Consulter les recommandations du fournisseur. Vérifiez les entrées prises en charge, le comportement des sorties, les outils, les paramètres et les exigences du client.
- Mettre à jour l’adaptateur dans un environnement de test. Vérifiez le bon fonctionnement de l’authentification, du formatage des requêtes, de l’analyse des réponses et de la gestion des erreurs.
- Exécuter des tâches éditoriales représentatives. Évaluez le modèle de remplacement à partir des mêmes briefs et dossiers de sources que ceux utilisés avec le modèle existant.
- Examiner les différences. Vérifiez l’étayage factuel, le respect des consignes, le ton, le formatage, la latence et le coût total du flux de travail.
- Déployer sur une file limitée. Maintenez la révision de publication en place tout en observant le modèle de remplacement sur des entrées réelles.
- Valider ou revenir en arrière. Ne mettez à jour l’association approuvée qu’une fois les critères de déploiement satisfaits.
Un modèle de remplacement peut produire un texte valide tout en modifiant le comportement de votre flux de travail. Il peut rédiger des introductions plus longues, interpréter différemment les restrictions sur les sources ou formater les champs structurés d’une manière inattendue pour votre analyseur. Testez l’ensemble du processus, au lieu de vérifier uniquement qu’un appel API aboutit.
Choisir délibérément entre une rotation au sein d’un fournisseur et une rotation entre fournisseurs
La rotation au sein d’un même fournisseur peut vous permettre de conserver une plus grande partie de l’intégration existante. Le passage à un autre fournisseur peut nécessiter davantage de travail sur les outils, les formats de requêtes et les résultats attendus. Aucune de ces approches ne dispense d’une évaluation éditoriale.
Le recours à plusieurs fournisseurs pour le basculement peut être utile lorsque la diversité des fournisseurs est une exigence explicite. Cela crée également un système supplémentaire à configurer, surveiller et approuver. Ne supposez pas que deux modèles sont interchangeables simplement parce qu’ils savent tous deux rédiger un paragraphe fluide.
Conservez la configuration précédente lorsqu’elle fonctionne encore et qu’elle reste prise en charge. Si elle n’est plus disponible, la solution de repli la plus sûre peut être de suspendre la publication et de continuer à collecter des brouillons, plutôt que de basculer automatiquement vers un modèle non testé.
Évaluer la qualité des modèles à partir de vos propres tâches de publication
Les descriptions générales des modèles peuvent vous aider à établir une liste restreinte, mais c’est votre charge de publication qui doit déterminer si un modèle est approuvé. Constituez un jeu d’évaluation réutilisable à partir des types d’articles et des problèmes éditoriaux que votre équipe rencontre réellement.
Incluez des tâches courantes et des cas difficiles. Un flux de travail performant pour une présentation générale simple peut échouer lorsque les sources sont contradictoires, qu’un brief contient des exclusions ou qu’un brouillon doit distinguer la documentation produit du langage marketing.
- Un brief contraignant : l’article doit répondre à une question précise sans s’étendre à des sujets sans rapport.
- Une lacune dans les éléments probants : une affirmation demandée ne dispose d’aucune source à l’appui et doit être signalée ou omise.
- Un cas de sources contradictoires : le modèle doit relever la contradiction au lieu de fusionner des affirmations incompatibles.
- Une tâche de formatage : le résultat doit respecter exactement les champs et les règles HTML attendus par votre outil de publication.
- Une révision éditoriale : le modèle doit améliorer la clarté sans introduire de nouvelles affirmations ni modifier le sens voulu.
Distinguer les échecs bloquants des préférences
Les affirmations factuelles non étayées, les mentions obligatoires manquantes, la structure de sortie défectueuse et les actions de publication non autorisées ne doivent pas être compensées par une prose élégante. Traitez-les comme des échecs bloquants.
D’autres qualités peuvent être évaluées à l’aide d’une grille éditoriale : la clarté, la profondeur, les répétitions, l’adéquation au public, l’utilité des titres et la quantité de révisions humaines nécessaires. Définissez explicitement ces critères afin que les réviseurs ne se contentent pas de choisir le style qu’ils préfèrent personnellement.
Dans la mesure du possible, demandez aux rédacteurs d’évaluer les résultats sans connaître le nom du modèle. Consignez leurs raisons, et pas seulement le modèle retenu. Une note indiquant qu’un résultat a omis une condition préalable est plus utile au débogage qu’un vague jugement selon lequel il semblait moins bon.
Ne modifier qu’une variable majeure à la fois
Lorsque vous comparez des modèles, gardez le brief, les éléments probants et les consignes inchangés. Si vous modifiez simultanément la consigne et le modèle, il devient plus difficile de déterminer la cause d’une amélioration ou d’une régression.
Après avoir sélectionné un modèle candidat, testez séparément les ajustements de consigne propres à ce modèle. Conservez un historique versionné de ces consignes afin de pouvoir reproduire les conditions dans lesquelles le modèle a été approuvé.
Répétez les évaluations lorsque le modèle, la consigne, le processus de collecte des sources ou l’intégration de publication change de manière importante. L’évaluation n’est pas une certification ponctuelle ; c’est le mécanisme qui rend la rotation contrôlée plutôt que spéculative.
Gérer conjointement les coûts, la latence et le comportement de secours
La requête de génération la moins coûteuse n’est pas nécessairement celle qui revient le moins cher sur l’ensemble du flux de publication. Un brouillon qui nécessite plusieurs réécritures, de nombreuses retouches ou du dépannage peut coûter plus cher au total qu’un brouillon produit par un modèle dont le tarif par requête est plus élevé.
Mesurez le coût à l’échelle de l’article et du flux de travail. Incluez la rédaction, les appels de vérification, les nouvelles tentatives, la recherche et le temps de révision humaine lorsque vous pouvez les suivre de manière cohérente. Évaluez la latence de la même façon : la mesure pertinente est souvent le temps nécessaire pour obtenir un brouillon approuvé, et non le délai avant la première réponse.
Encadrer les révisions automatisées
Une boucle de révision a besoin d’une règle d’arrêt. Si un brouillon échoue à plusieurs reprises au même contrôle des éléments probants, demander à un autre modèle de le réécrire risque seulement de produire une version plus soignée de la même affirmation non étayée.
- Fixez un nombre maximal de tentatives de révision automatisées pour chaque étape.
- Renvoyez des erreurs de validation précises à l’étape concernée au lieu de régénérer par défaut l’article entier.
- Transmettez les éléments probants manquants à la recherche ou à un rédacteur, et non simplement à un modèle de rédaction plus performant.
- Réutilisez les étapes intermédiaires approuvées lorsque le brief et le dossier de sources n’ont pas changé.
Distinguez les défaillances opérationnelles des problèmes éditoriaux. Une erreur de service temporaire peut justifier une nouvelle tentative ou l’utilisation d’un modèle de secours approuvé. Un manque d’étayage factuel exige une décision sur le contenu. Traiter les deux comme des erreurs génériques peut transformer la résilience de l’infrastructure en réécriture incontrôlée.
Définir la marche à suivre lorsqu’aucun modèle approuvé n’est disponible
Une politique de secours doit préciser les tâches admissibles, les solutions de remplacement approuvées et les conditions d’arrêt du flux de travail. Un modèle approuvé pour les métadonnées ne doit pas se voir confier automatiquement une vérification technique parce que le réviseur privilégié est indisponible.
Pour le contenu planifié, maintenez une file de publication approuvée lorsque cela est approprié. Si la génération est interrompue, les articles déjà approuvés peuvent rester séparés des travaux incomplets. N’abaissez pas le seuil éditorial simplement pour remplir une plage de publication.
Surveillez les motifs d’échec ainsi que les dépenses. Des erreurs de formatage répétées appellent une intervention différente de celle requise par des lacunes récurrentes dans les sources. De bons journaux opérationnels vous aident à déterminer s’il faut ajuster le modèle, les consignes, le processus de collecte des sources ou l’intégration.
Déployer l’automatisation progressivement, puis réutiliser le contenu approuvé
Introduisez l’automatisation par étapes afin de pouvoir observer les échecs avant qu’ils n’atteignent les lecteurs. Commencez par une catégorie d’articles restreinte dont les sources, la structure et les exigences de révision sont bien définies.
Vous pourriez, par exemple, commencer par des articles explicatifs fondés sur une documentation interne approuvée, plutôt que par des articles nécessitant des recherches ouvertes. Il s’agit d’un choix de mise en œuvre, et non d’une garantie d’exactitude ; les mêmes exigences en matière de preuves et d’approbation restent applicables.
- Assister le processus existant. Générez des briefs, des plans et des métadonnées, tout en laissant aux rédacteurs le contrôle des décisions de rédaction et de publication.
- Automatiser la préparation des brouillons. Reliez les éléments probants approuvés aux étapes de rédaction et de vérification, puis transmettez le résultat à un rédacteur humain.
- Automatiser la préparation de la publication. Créez des brouillons d’articles, validez le contenu affiché et préparez les informations de planification.
- Élargir le périmètre uniquement après examen. Ajoutez des catégories d’articles ou des autorisations lorsque les résultats de l’évaluation et les journaux opérationnels justifient ce changement.
Utiliser les articles approuvés comme source pour d’autres canaux
Le guide sur l’IA de la Canadian Marketing Association décrit la réutilisation de contenus de blog sous forme de publications sur les réseaux sociaux, d’e-mails et de présentations. Dans un flux de travail gouverné, ces contenus dérivés doivent provenir de l’article approuvé, et non d’un brouillon antérieur ou de la consigne de génération initiale.
Définissez des contraintes propres à chaque canal. Une publication sur les réseaux sociaux peut nécessiter une formulation concise et un lien ; un e-mail peut devoir apporter du contexte à un autre public. La condensation du contenu ne doit pas supprimer une réserve qui modifie le sens de l’affirmation.
La rotation des modèles peut également s’appliquer ici. Une tâche de réutilisation du contenu bien cadrée peut faire appel à un modèle approuvé différent de celui utilisé pour l’article d’origine. Évaluez sa capacité à préserver le sens de l’article plutôt que de juger uniquement si le résultat est accrocheur.
Attribuer les responsabilités après le lancement
Désignez un responsable de la qualité éditoriale, de la configuration des modèles et des opérations de publication, même si une seule personne assume initialement les trois rôles. Quelqu’un doit intervenir lorsqu’une source change, qu’une intégration échoue ou qu’un fournisseur annonce le retrait d’un modèle.
Suivez les corrections et les commentaires des rédacteurs en parallèle des journaux techniques. Ces données révèlent des problèmes que les appels API réussis ne peuvent pas mettre en évidence : explications répétitives, limites omises, résumés trompeurs ou contenus qui ne répondent pas à la question du lecteur.
Le flux de travail est prêt à être élargi lorsque ses décisions sont compréhensibles et que ses échecs peuvent être corrigés. L’automatisation ne doit progresser qu’après que le contrôle a fait ses preuves, et non s’y substituer.
Pour automatiser la publication d’un blog grâce à la rotation des modèles d’IA, commencez par définir un processus éditorial, des associations explicites entre tâches et modèles, ainsi qu’une vérification fondée sur des éléments probants. Séparez la configuration des modèles de la logique métier, testez les remplaçants avant leur déploiement et réservez l’autorité de publication à une étape finale contrôlée.
Commencez par cartographier le parcours d’un type d’article, du brief à l’article planifié. Constituez un petit jeu d’évaluation, approuvez un modèle principal et, si nécessaire, un modèle de secours pour chaque rôle, puis exécutez le processus en mode brouillon uniquement jusqu’à pouvoir expliquer de manière fiable ce qui est accepté, ce qui est rejeté et qui prend la décision finale.